Partie 9 : Découper le stockage des tables en pages
Lecture 5 min. •
Table des matières
Les articles de la série
- Partie 1 : Construire le REPL
- Partie 2 : Sérialisation des données
- Partie 3 : Database
- Partie 4 : Tables
- Partie 5 : Parser les commandes, création de la boîte à outils
- Partie 6 : Parser les commandes SQL
- Partie 7 : Tuples de données
- Partie 8 : Contraindre les données via un schéma
- Partie 9 : Découper le stockage des tables en pages
- Partie 10 : Clefs primaires
- Partie 11 : Expressions Logiques SQL
- Partie 12 : Scans et filtrage
- Partie 13 : UTF-8 et caractères échappés
- Partie 14 : Attributs nullifiables
- Partie 15 : Index secondaires
- Partie 16 : Directive EXPLAIN
- Partie 17 : Logical Plan
- Partie 18 : Exécution du plan logique
- Partie 19 : Suppression d'enregistrements
- Partie 20 : Réindexation et compactation de tables
Bonjour à toutes et tous 😃
Petit article (en comparaison des autres 😅).
Bien que l’on soit en train de réimplémenter tout et n’importe quoi pour notre plaisir et notre apprentissage à la fois dans Rust et dans la création de base de données.
Notre objectif est de créer un sqlite, et qui dit sqlite, dit persistance sur disque.
Pour le moment, toutes nos opérations sont in-memory, on peut se permettre de scanner la mémoire pour un coup modique. Même si on a plusieurs centaines de mégaoctets le délais de scan de la table reste acceptable.
Par contre si on commence à stocker sur disque, un problème de taille (et c’est le cas de le dire) va intervenir: lire un fichier est LENT !!
Pour éviter cette lenteur, il faut absolument le “monter en mémoire”, mais on ne va pas monter 2Go de base de données!
La solution est de le découper en plusieurs unité logique que nous allons appeler des pages.
Ces pages seront bien plus petites que le fichier de la base de données et permettront par la suite de faire des opérations de cache très intéressantes. 😎
Ces dans ces pages que nous allons stocker nos données et donc nos tuples.
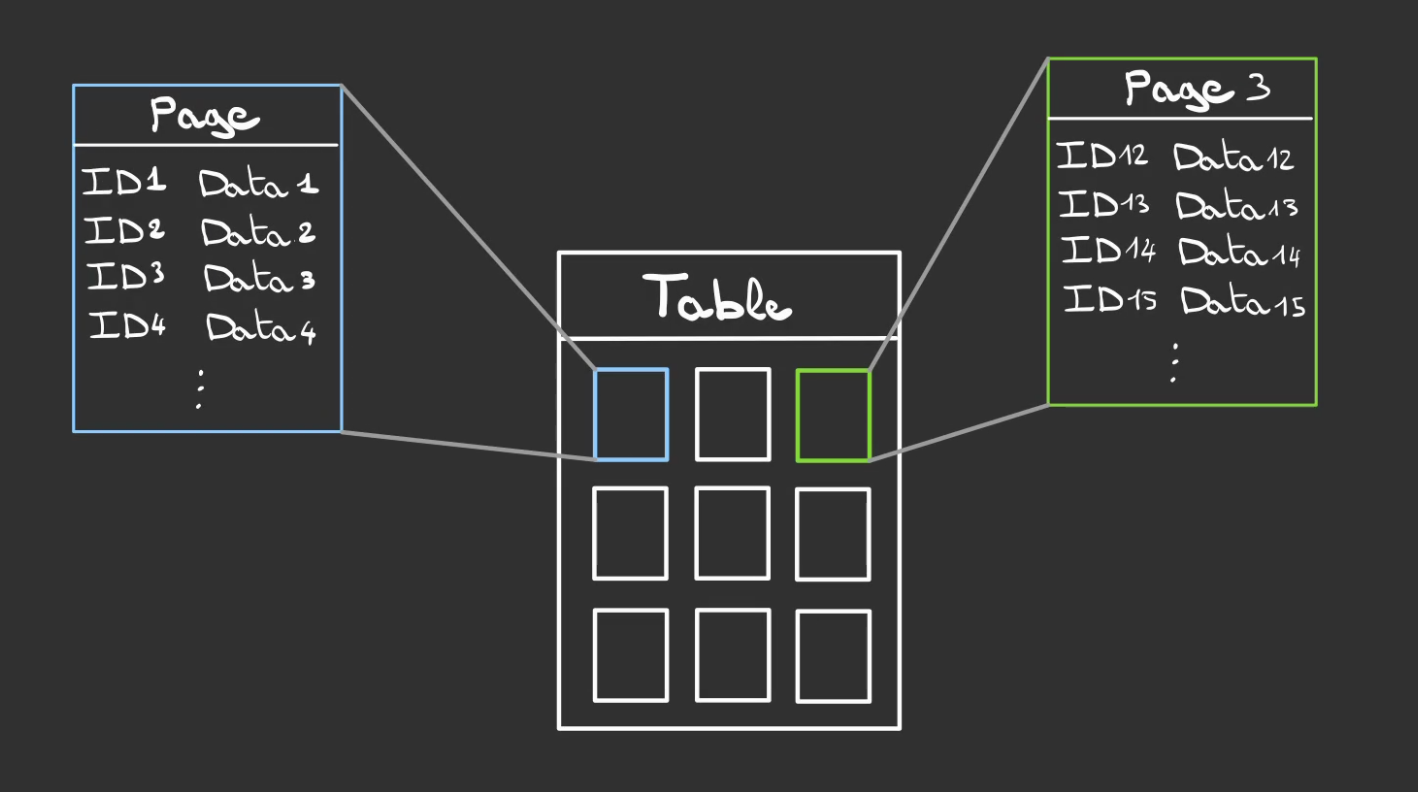
La notion cruciale que nous allons devoir respecter pour espérer récupérer quoique ce soit de page est que chaque données doit avoir rigoureusemet la même taille.
Heureusement, c’est déjà la cas grâce à notre Schéma qui contraint désormais nos tuples à respecter toutes les règles que l’on lui dicte avant insertion des dites données dans la table.
Nous pouvons alors implémenter le trait Size sur le Schéma
impl Size for Schema {
    fn size(&self) -> usize {
        self.fields
            .values()
            .map(|column| column.size())
            .sum::<usize>()
    }
}
Cela est possible car chaque ColumnType connaît très exactement la place qu’il prend. On peut donc sommer ces emplacements pour obtenir la taille du tuple en mémoire.
impl Size for ColumnType {
    fn size(&self) -> usize {
        match self {
            ColumnType::Integer => size_of::<i64>(),
            ColumnType::Text(size) => *size,
        }
    }
}
Nous allons nous retrouver dans cette configuration.
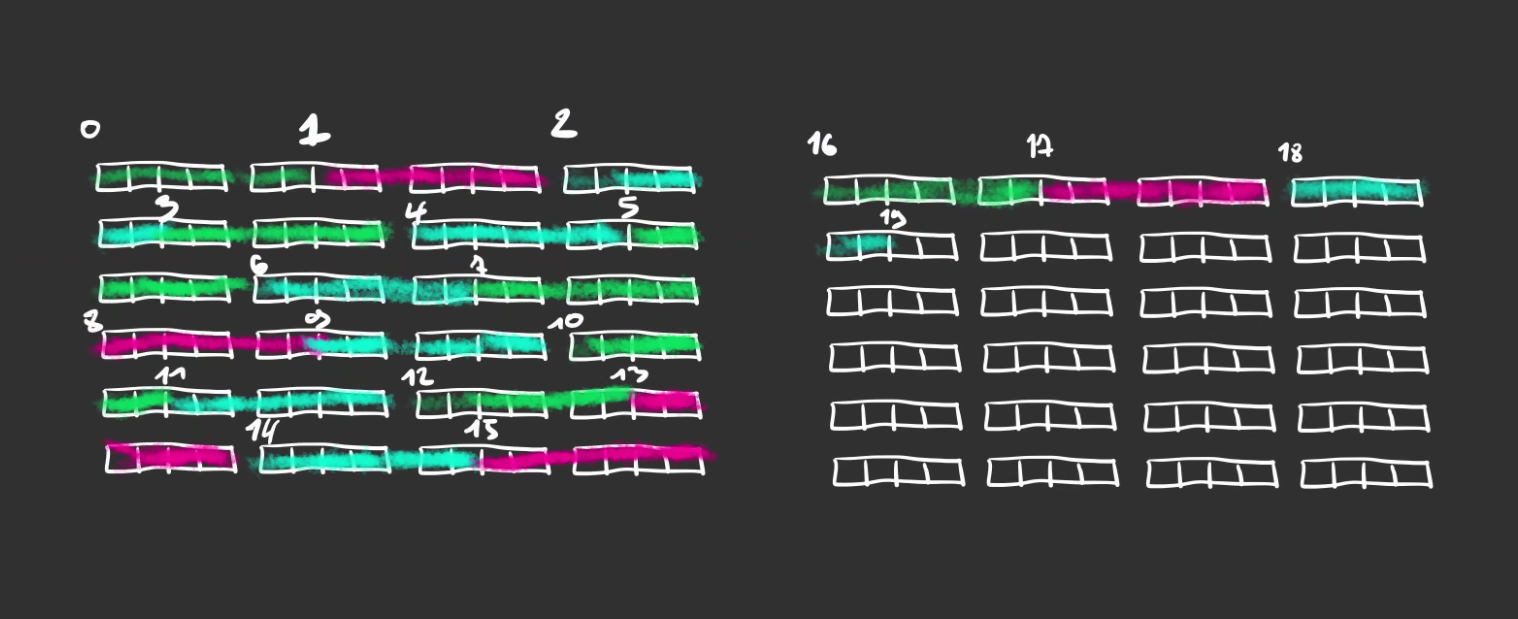
Chaque tuple d’une table prend la même place et on peut alors les sérialiser les uns après les autres.
Ici j’ai représenté deux pages de 96 cases et des tuples de 6 cases.
En faisant la division on se retrouve avec 96 / 6 = 16 tuples stockables dans une page. Le 17ème se trouvant dans la page suivante (on commence à 0 les index).
Mais attention! Si la taille du tuple n’est pas aussi sympathique, comme 7 cases par exemple, nous allons observer un phénomène de fragmentation de la donnée qui se retrouve sur plus d’une page, on nomme ça du désalignement.
En effet 96 / 7 = 13.7.., le 14ème élément va se retrouver coupé en deux.
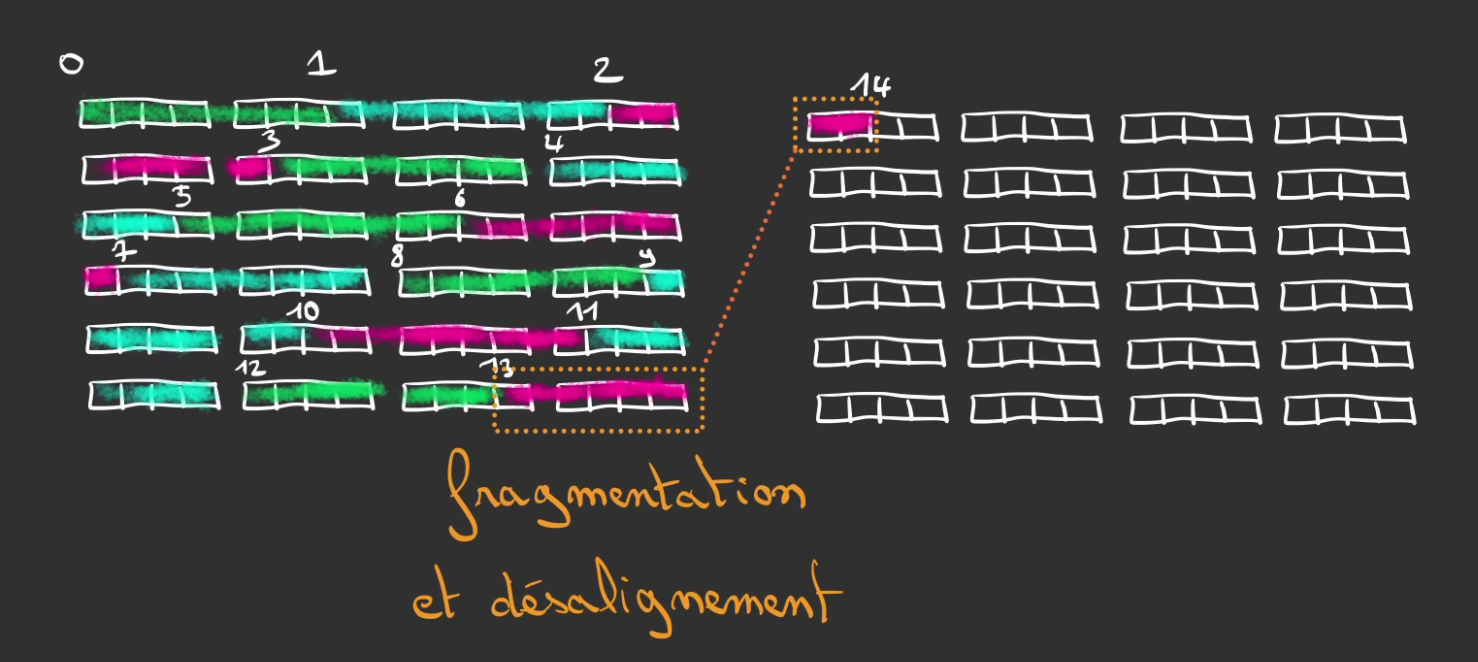
Pour contrer ce phénomène, nous allons condamner les cases qui provoquent ce désalignement.
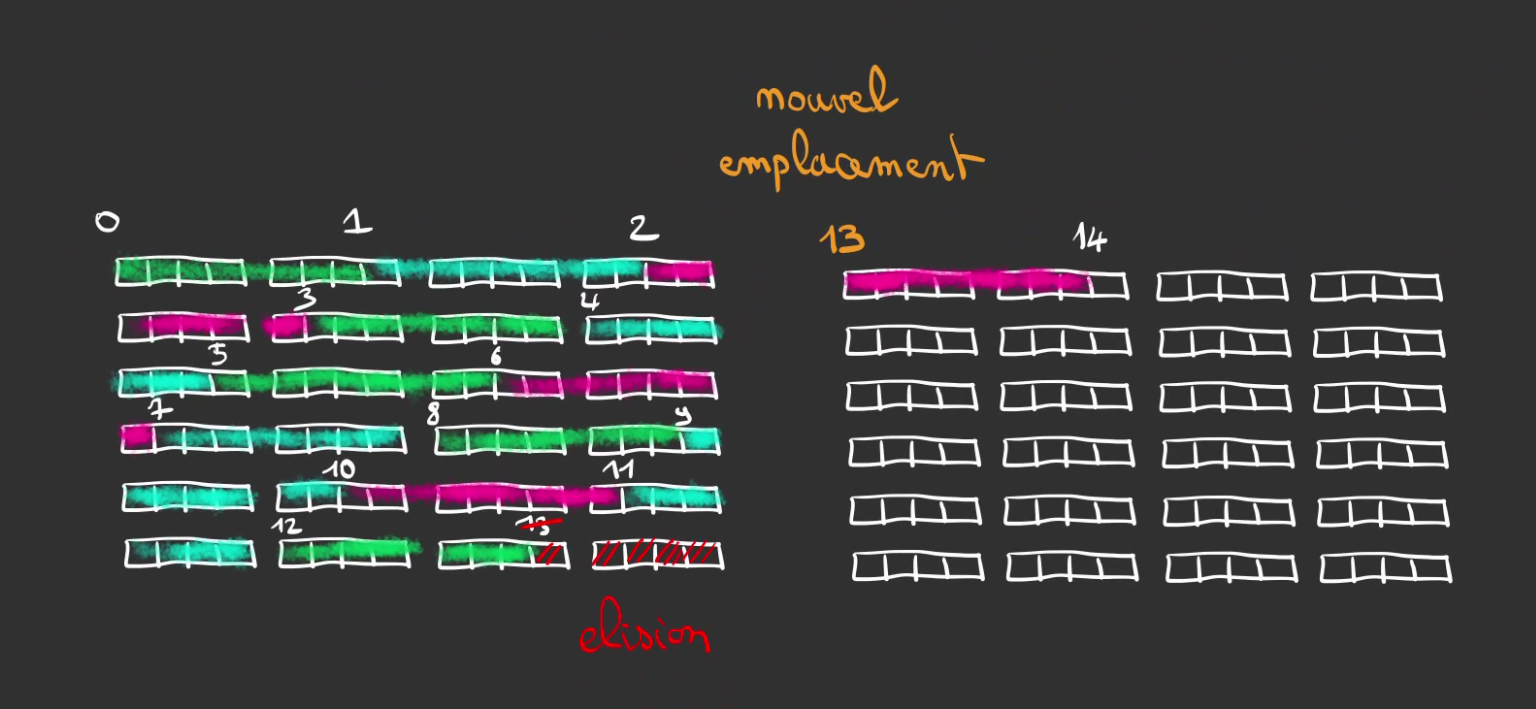
Ainsi, le début 14ème élément est désormais déplacé dans la deuxième page, ce qui résout le désalignement.
C’est bien beau de pouvoir stocker de la donnée dans nos pages, encore faut-il pouvoir les lire après coup.
Pour cela, nous allons utiliser une arme des plus commode : les mathématiques !! 😇
Déjà calculons la taille de la page. Prenons arbitrairement 4096 octets, c’est la taille d’un bloc de données dans plusieurs système de fichier, ça accèlerera les opérations.
Nous l’appellerons en majuscules : PAGE_SIZE.
Pour éviter les désalignements en fonction de la taille du tuple row_size, nous devons tronquer cette taille.
page_size = (PAGE_SIZE // row_size) * row_sizeCela nous donne un page_size en minuscule cette fois.
Le symbole
//est la division entière, on ne peut pas simplifier “en haut et en bas” parrow_size.
Pour retrouver la position du tuple d’index row_number, il faut d’abord trouver sa page.
page_number =  (row_number * row_size) // page_size
               ^---------------------^
                      index global
Ce qui revient à mettre à plat toute nos pages tronquées et à définir l’index global dans cette immense tableau, puis à diviser cette index par la taille d’une page tronquée.
Pour trouver la position du tuple dans cette page son offset, on va alors utiliser la même technique, on calcul l’index global global_index, mais cette fois ci au lieu de diviser, on soustrait les tailles de pages qui ne sont pas la page sélectionnée.
offset = global_index - page_number * page_sizeEn cumulant ces deux informations, il est possible de retrouver notre tuple dans les pages, vive les maths! 🤩
Matérialisons tout ça.
D’abord, on se créé une structure Page qui sera notre page.
pub const PAGE_SIZE: usize = 4096;

pub struct Page {
    inner: [u8; PAGE_SIZE],
}

impl Page {
    pub fn new() -> Self {
        Page {
            inner: [0u8; PAGE_SIZE],
        }
    }
}
Si on demande la taille d’une page, on aura très exactement
4096bytes.
On lui ajoute deux méthodes qui permettent d’accéder en lecture et en écriture à une zone de la page.
impl Page {
    pub fn get_mut(&mut self, offset: usize) -> &mut [u8] {
        &mut self.inner[offset..]
    }

    pub fn get(&self, offset: usize) -> &[u8] {
        &self.inner[offset..]
    }
}
On peut maintenant définir un objet Pager qui aura pour rôle de maintenir les pages.
pub struct Pager {
    // les pages sont stockées dans une map
    // qui associe le page_num et la page elle même
    pages: BTreeMap<usize, Page>,
    page_size: usize,
    row_size: usize,
}

impl Pager {
    pub fn new(row_size: usize) -> Self {
        // tronque la page size pour éviter le désalignement
        let page_size = (PAGE_SIZE / row_size) * row_size;
        Pager {
            pages: BTreeMap::default(),
            row_size,
            page_size,
        }
    }
}
Lors de la création du pager, on y calcule notre fameuse taille tronquée.
On peut alors définir notre méthode qui réalise l’opération mathématique de récupération le page et de son offset.
impl Pager {
    fn get_position(&self, row_number: usize) -> Position {
        // calcul de l'index global
        let global_index = row_number * self.row_size;
        // calcul la page contenant le record
        let page_number = global_index / self.page_size;
        // calcul l'offset de la valeur dans cette page
        let offset = global_index - page_number * self.page_size;
        Position {
            page_number,
            offset,
        }
    }
}
On défini pour l’occasion une structure de Position
struct Position {
    page_number: usize,
    offset: usize,
}
Pour finalement définir deux méthodes qui permettent respectivement de récupérer une slice en lecture et en écriture, positionné au début du tuple demandé.
impl Pager {

    pub fn write(&mut self, row_number: usize) -> &mut [u8] {
        let Position {
            page_number,
            offset,
        } = self.get_position(row_number);

        // si la page n'existe pas elle est allouée à la volée
        self.pages
            .entry(page_number)
            .or_insert_with(Page::new)
            .get_mut(offset)
    }

    pub fn read(&self, row_number: usize) -> Option<&[u8]> {
        let Position {
            page_number,
            offset,
        } = self.get_position(row_number);

        match self.pages.get(&page_number) {
            None => None,
            Some(page) => Some(page.get(offset)),
        }
    }
}
On peut alors finalement modifier la table pour lui rajouter le Pager et lui retirer la slice de data.
pub struct Table {
    pub(crate) schema: Schema,
    row_number: usize,
    pager: Pager,
}

impl Table {
    pub fn new(schema: Schema) -> Self {
        Self {
            pager: Pager::new(schema.size()),
            schema,
            row_number: 0,
        }
    }
}
Et finalement utiliser le pager dans nos commandes d’insertions
impl Table {
    pub fn insert(&mut self, row: &HashMap<String, Value>) -> Result<(), InsertionError> {
        // récupération de la slice de données en écriture du tuple
        let page = self.pager.write(self.row_number);

        let mut writer = Cursor::new(page);
        // appel à la sérialisation au travers du schéma
        // la vérification est également faite à ce moment
        self.schema
            .serialize(&mut writer, row)
            .map_err(InsertionError::Serialization)?;
        // self.offset += writer.position() as usize;
        self.row_number += 1;
        Ok(())
    }
}
Et de sélection, pour le moment on déclare une erreur si la page n’existe pas, dans l’avenir on dira que la donnée n’existe pas.
impl Table {
    pub fn select(&self) -> Result<Vec<Vec<Value>>, SelectError> {
        let mut rows = Vec::with_capacity(self.row_number);

        for row_number in 0..self.row_number {
            let page = self.pager.read(row_number).ok_or(SelectError::PageNotExist(row_number))?;
            let mut reader = Cursor::new(page);
            rows.push(
                // désérialisation par le schéma
                self.schema
                    .deserialize(&mut reader)
                    .map_err(SelectError::Deserialization)?,
            )
        }
        Ok(rows)
    }
}
Conclusion
Un article court et globalement technique, les tests unitaires n’ont pas bougé d’un poil car les modifications sont purement internes.
Mais le travail que nous avons faut va nous ouvrir la voie dans les prochaines parties sur plein d’optimisations très intéressantes comme du cache LRU.
Dans la prochaine partie, nous verrons les index primaires et comment récupérer de la données autrement qu’en scannant toute la table !
Merci de votre lecture ❤️